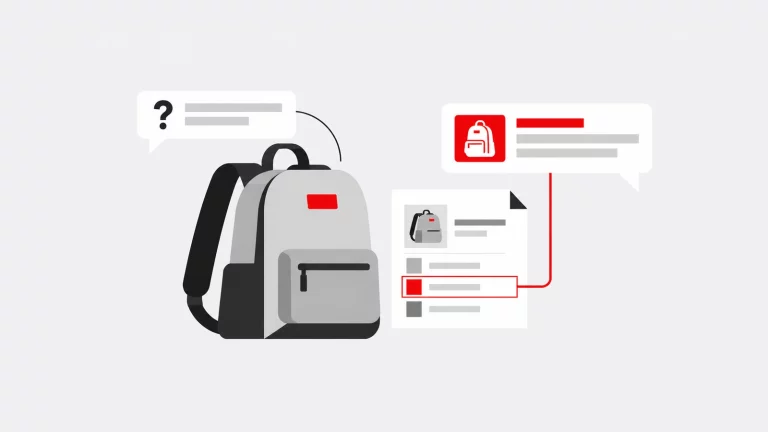


Um chatbot com IA pode explicar assuntos complexos e, ainda assim, responder incorretamente sobre a empresa que representa. O modelo pode ter conhecimentos gerais, mas desconhecer os serviços, produtos, condições comerciais ou procedimentos dessa organização.
É para colmatar esta diferença que serve uma base de conhecimento: um conjunto selecionado e organizado de informações que o sistema pode pesquisar para fundamentar as respostas. Pode incluir páginas do website, artigos, perguntas frequentes, documentação ou catálogos. A qualidade depende tanto do que se inclui como do que se decide excluir.
Como funciona uma base de conhecimento?
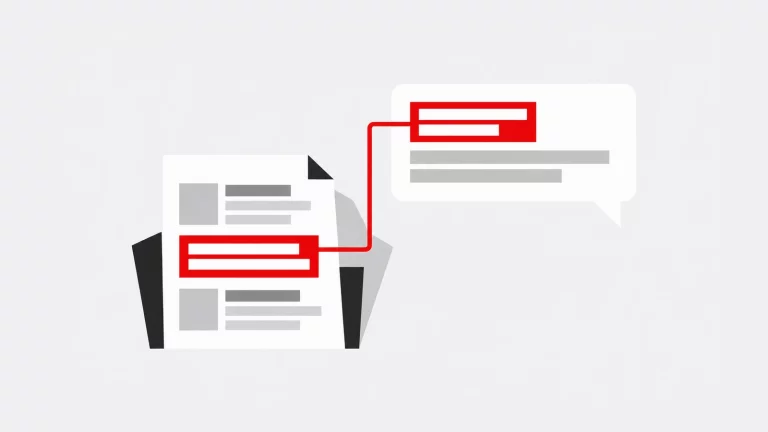
Numa implementação comum, quando alguém faz uma pergunta, o sistema procura informação relevante nas fontes preparadas, recupera os excertos mais úteis e fornece-os ao modelo de linguagem como contexto. Este utiliza-os para formular a resposta. A abordagem é conhecida como RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação de informação).
O chatbot não precisa de ler todos os documentos a cada pergunta. Também não significa que todo o conteúdo fique permanentemente incorporado no modelo.
Consultar informação não é o mesmo que treinar a IA
Adicionar páginas ou PDFs a uma base de conhecimento não equivale, por si só, a treinar um novo modelo. Na recuperação de informação, o conteúdo é pesquisado quando necessário; no ajuste fino de um modelo (fine-tuning), são utilizados exemplos para modificar os seus parâmetros e comportamento.
Esta distinção tem consequências práticas. Se uma política comercial mudar, normalmente é necessário atualizar a fonte e o respetivo índice de pesquisa, em vez de voltar a treinar o modelo. A atualização só é eficaz se o sistema passar a recuperar a versão correta e deixar de utilizar informação obsoleta.
Que conteúdos devem fazer parte da base?
Num website empresarial, existem várias fontes possíveis. Incluir todo o website pode ser tecnicamente viável, mas raramente deve ser uma decisão automática. Cada fonte precisa de ser avaliada pela utilidade, atualidade e fiabilidade.
| Fonte | O que verificar antes de incluir |
|---|---|
| Páginas de serviços e institucionais | Explicam claramente o serviço, destinatários, condições e limitações? |
| Artigos, perguntas frequentes e portefólio | Respondem a dúvidas concretas e continuam atualizados? |
| Manuais, fichas técnicas, catálogos e PDFs | O texto e as tabelas podem ser extraídos e interpretados corretamente? |
| Páginas de produto e políticas | A informação é válida e existe uma fonte oficial para alterações? |
Uma página que diz apenas «Criamos soluções inovadoras para cada cliente» acrescenta pouco à base. Uma explicação que identifica o que está incluído no serviço, as condições aplicáveis e as exceções permite responder a perguntas concretas.
Os PDFs exigem atenção especial
A possibilidade de carregar PDFs não garante que o sistema consiga interpretar tudo o que contêm. Documentos digitalizados, tabelas complexas, esquemas ou páginas com várias colunas podem exigir extração de texto adicional e validação. Convém testar perguntas cujas respostas estejam nesses elementos, em vez de assumir que o ficheiro foi processado sem perdas.
Os artigos antigos também merecem revisão antes de serem incluídos. Uma explicação desatualizada pode ser encontrada e apresentada com a mesma confiança aparente de um documento recente.
Como encontra o chatbot a informação relevante?
Muitas soluções utilizam pesquisa semântica, que procura conteúdos relacionados pelo significado, mesmo quando não contêm exatamente as palavras da pergunta. Outras combinam esse método com pesquisa por palavras-chave.
Imagine que um visitante pergunta se a empresa disponibiliza pagamento a prazo. O documento relevante pode referir «condições de pagamento diferido para clientes empresariais aprovados». A pesquisa semântica pode identificar a relação entre estas expressões, mas o chatbot terá de preservar a condição de aprovação na resposta.
A importância dos excertos e da estrutura
Para pesquisar um manual com 80 páginas, é habitual dividir o texto em partes menores, ou excertos (chunks). Assim, o sistema pode recuperar a secção sobre garantias sem enviar o manual inteiro ao modelo. Se os excertos forem demasiado pequenos, podem perder contexto; se forem demasiado grandes, podem trazer informação irrelevante.
A forma como o conteúdo está escrito também influencia o resultado. Compare dois exemplos hipotéticos:
Pouco esclarecedor: «Esta opção depende das condições mencionadas anteriormente.»
Mais útil: «Clientes B2B aprovados podem enviar encomendas sem pagamento imediato quando têm condições comerciais previamente definidas.»
O segundo texto identifica o destinatário, a possibilidade e a condição aplicável. Mantém o sentido mesmo quando é recuperado fora da página original. Títulos descritivos e secções autónomas ajudam tanto o leitor como o sistema de pesquisa.
Porque é que mais conteúdo não significa melhores respostas?
Uma base extensa pode conter duplicados, documentos ultrapassados e afirmações contraditórias. Imagine que uma página antiga afirma que a manutenção mensal está incluída num serviço e a página atual indica que é opcional. Se ambas forem pesquisáveis, o chatbot pode utilizar a informação errada.
A correção deve começar na origem: resolver a contradição, identificar a fonte válida e retirar ou desvalorizar a versão antiga na pesquisa. Melhorar apenas as instruções do chatbot não corrige um conjunto de fontes incoerentes.
É útil definir uma fonte de referência por assunto. A página oficial do serviço pode estabelecer as condições comerciais, enquanto um artigo explica conceitos relacionados. Os arquivos históricos podem continuar disponíveis para consulta humana sem serem utilizados para responder sobre condições atuais.
Algumas soluções permitem associar atributos aos documentos — idioma, categoria, produto, data ou estado de validade — e filtrar os resultados. Estes mecanismos ajudam a organizar a pesquisa, mas a prioridade editorial só tem efeito quando é refletida na seleção, nos filtros ou nas regras efetivas de recuperação.
A atualização faz parte do funcionamento
A base precisa de acompanhar alterações de serviços, preços, documentos e políticas. Conforme a solução, pode existir sincronização automática, reindexação programada ou atualização manual. Em qualquer caso, é necessário confirmar que as alterações chegaram ao índice e que as versões antigas deixaram de interferir nas respostas.
Informação muito dinâmica, como disponibilidade de produtos ou estado de encomendas, pode exigir uma integração que consulte o sistema de origem em tempo real. Uma base documental atualizada periodicamente não substitui essa consulta.
Que cuidados deve ter com informação reservada?
Um chatbot público não deve responder com dados privados apenas porque esses dados estão no mesmo WordPress, servidor ou repositório documental. Páginas públicas, áreas de cliente, documentos internos e dados pessoais têm requisitos de acesso diferentes.
Num sistema com informação reservada, é necessário verificar a identidade e as permissões do utilizador antes de disponibilizar os resultados da pesquisa. Isto exige controlos na aplicação e na recuperação dos documentos, não apenas uma instrução ao modelo para «não revelar» informação. Criar chatbots separados também não garante, por si só, isolamento entre as respetivas fontes.
O sistema deve ainda tratar os documentos recuperados como informação a consultar, não como instruções com autoridade para alterar o seu comportamento. Conteúdos externos ou manipulados podem tentar influenciar indevidamente a resposta.
Uma boa base de conhecimento elimina as respostas erradas?
Não. Uma base bem preparada pode melhorar a fundamentação das respostas, mas continua a haver várias possibilidades de falha:
- Informação em falta ou incorreta:
- a fonte não responde à pergunta, está incompleta ou contém um erro.
- Pesquisa inadequada:
- a informação certa existe, mas o sistema recupera outro excerto.
- Interpretação errada:
- o modelo recebe o excerto correto, mas omite uma condição ou tira uma conclusão que a fonte não permite.
Num chatbot empresarial, é prudente definir o que acontece quando não existe informação suficiente: reconhecer a limitação, evitar inventar condições e, quando adequado, encaminhar a questão para a empresa. Apresentar a fonte consultada também pode facilitar a verificação, embora uma referência não garanta, por si só, que a interpretação esteja correta.
Como avaliar a base antes de publicar o chatbot?
A preparação deve incluir uma revisão dos conteúdos e testes com perguntas representativas de situações reais:
- Atualidade:
- os serviços, políticas e documentos estão corretos? Foram retiradas versões ultrapassadas?
- Coerência:
- existem duplicados ou contradições sobre o mesmo assunto?
- Qualidade documental:
- os títulos são claros e os PDFs disponibilizam o texto necessário?
- Fontes oficiais:
- está definido qual o documento de referência para cada informação relevante?
- Acessos:
- o chatbot público fica impedido de consultar conteúdos reservados? As permissões são verificadas no sistema?
- Respostas:
- o chatbot encontra a informação certa, respeita exceções e reconhece quando não sabe responder?
- Manutenção:
- existe alguém responsável pelas atualizações e pela verificação posterior das respostas?
Vale a pena testar perguntas diretas, formulações ambíguas, pedidos sem resposta disponível e tentativas de obter informação reservada. Avaliar apenas se o chatbot escreve de forma natural não demonstra que a base funciona corretamente.
Conclusão
Uma base de conhecimento eficaz resulta de selecionar, estruturar, proteger e manter informação fiável. O chatbot precisa de recuperar as fontes adequadas, interpretar corretamente o seu conteúdo e reconhecer os próprios limites.
A tecnologia de pesquisa é importante, mas a qualidade começa nas fontes e nas regras que definem como podem ser utilizadas.