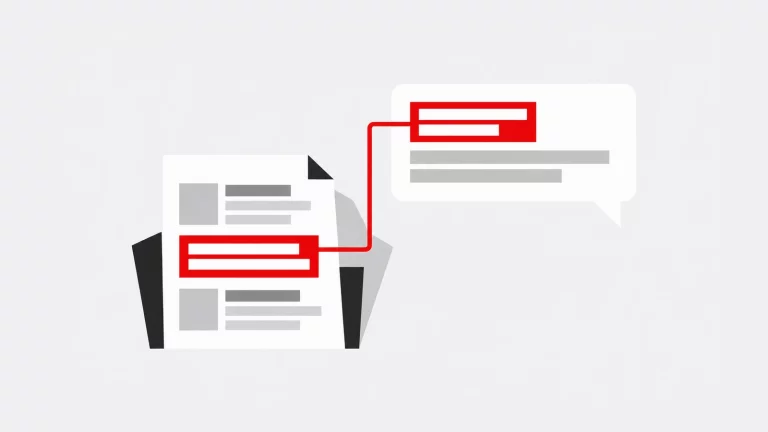


Quando um chatbot está ligado a dezenas de páginas, artigos ou PDFs, não precisa, em muitas arquiteturas, de ler todos esses documentos a cada pergunta. O conteúdo é preparado e indexado antecipadamente; depois, um sistema de pesquisa seleciona os excertos que parecem mais relevantes para a resposta.
É nesta etapa que entram o chunking, os embeddings e a pesquisa semântica. Compreender como funcionam ajuda a explicar por que razão um chatbot pode responder mal, mesmo quando a informação correta está na sua base de conhecimento.
Antes de responder, o sistema precisa de encontrar informação
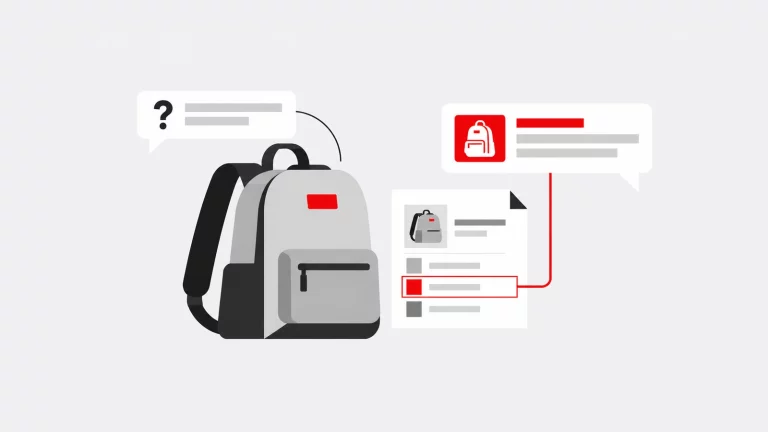
Imagine uma base de conhecimento com 80 páginas de um website, 150 artigos, 40 PDFs, documentação técnica e perguntas frequentes. Um visitante pergunta: «Qual é o prazo de entrega para Portugal Continental?»
Enviar todos os documentos ao modelo seria, em geral, desnecessário, dispendioso e pouco eficiente. Em vez disso, a aplicação tenta recuperar os trechos relacionados com os prazos de entrega.
Documentos → divisão em blocos → embeddings e indexação → pesquisa e ordenação → contexto → modelo → resposta
Esta é uma representação simplificada de uma arquitetura frequente de geração aumentada por recuperação (RAG). A pesquisa e seleção da informação, também designada retrieval, acontece antes de o modelo produzir a resposta. A implementação exata varia entre plataformas.
Chunking: dividir documentos sem perder o contexto
Chunking é a divisão de documentos em blocos de conteúdo (chunks) que podem ser indexados e recuperados separadamente. Num PDF extenso sobre condições comerciais, por exemplo, interessa encontrar a passagem sobre devoluções, sem enviar também as secções de pagamentos, faturação e apoio técnico.
A dificuldade está em escolher onde dividir. Considere este exemplo ilustrativo:
Exemplo: «O prazo normal de entrega em Portugal Continental é de 3 a 5 dias úteis. Para as ilhas, o prazo pode ser superior.»
Se a divisão separar as duas frases e a pesquisa recuperar apenas a primeira, o chatbot pode omitir a exceção. A informação continua no documento, mas o excerto selecionado já não contém tudo o que é necessário.
Blocos pequenos, grandes e com sobreposição
Blocos demasiado pequenos podem separar uma regra da respetiva exceção, uma pergunta da resposta ou um produto das suas especificações. Blocos demasiado grandes podem juntar assuntos distintos, diluir a relevância da passagem procurada e ocupar desnecessariamente o contexto enviado ao modelo.
Algumas estratégias utilizam sobreposição entre blocos (overlap), repetindo uma parte do texto no bloco seguinte para reduzir perdas nas zonas de corte. É útil quando uma explicação atravessa a fronteira entre dois blocos, mas uma sobreposição excessiva cria duplicação, aumenta o volume indexado e pode produzir resultados quase iguais.
Não existe um tamanho universal. Uma resposta curta a uma pergunta frequente pode constituir um bloco autónomo; uma cláusula contratual pode exigir que várias condições fiquem juntas. Também importa respeitar títulos, parágrafos e limites de secções sempre que a tecnologia o permitir. A qualidade deve ser avaliada pelas perguntas que o sistema consegue responder, não apenas pelo número de palavras ou tokens definido na configuração.
Embeddings: encontrar significado, não apenas palavras iguais
Um embedding é uma representação numérica de um texto, sob a forma de um vetor. Na preparação da base, um modelo de embeddings transforma os blocos de texto em vetores. Quando surge uma pergunta, esta também pode ser representada por um vetor, permitindo comparar a proximidade semântica entre ambos.
Imagine que o visitante pergunta: «Quanto tempo demora a encomenda a chegar?» A base contém a frase: «As entregas em Portugal Continental são efetuadas normalmente em 3 a 5 dias úteis.» Embora as palavras sejam diferentes, a pesquisa semântica pode reconhecer que os dois textos tratam do mesmo assunto.
O embedding não é uma cópia legível do documento nem uma memória literal do chatbot. É um instrumento de comparação. Proximidade semântica não significa, por si só, que uma passagem seja verdadeira, atual ou suficiente para responder.
Esta pesquisa pode utilizar uma base de dados vetorial ou um serviço que inclua armazenamento e pesquisa de vetores. Não é obrigatório instalar ou gerir uma base de dados vetorial própria: existem plataformas que tratam da indexação e recuperação como serviço.
Pesquisa híbrida e ordenação dos resultados
A pesquisa semântica não substitui todas as vantagens da pesquisa por palavras. Nomes de produtos, códigos, referências, siglas ou versões exigem muitas vezes correspondência textual precisa.
Numa pergunta como «A referência MX-204 é adequada para instalação exterior?», há duas necessidades: identificar exatamente MX-204 e compreender o significado de instalação exterior. Uma pesquisa híbrida combina sinais de correspondência textual com sinais de proximidade semântica. A forma de os combinar depende do motor de pesquisa.
Depois de identificar os candidatos, o sistema ordena-os por relevância (ranking). Algumas soluções voltam a avaliar e reordenar os candidatos depois da primeira pesquisa. O número de resultados selecionados é frequentemente controlado por um parâmetro chamado top-k ou por uma configuração equivalente.
Recuperar poucos excertos pode deixar de fora uma condição importante; recuperar demasiados pode introduzir duplicados, documentos desatualizados e informação lateral. O objetivo é enviar ao modelo contexto suficiente, relevante e coerente, não o maior volume possível de texto.
Metadados, filtros e permissões
Além do conteúdo, os documentos podem incluir metadados: idioma, categoria, tipo de documento, região, data ou estado de publicação. Estes atributos ajudam a restringir a pesquisa antes ou durante a seleção dos resultados.
Se alguém perguntar pela garantia de um produto em Portugal, por exemplo, um filtro de região pode evitar que a pesquisa devolva condições relativas a outros mercados. Da mesma forma, distinguir documentação em vigor de documentos arquivados reduz o risco de apresentar regras antigas.
Os metadados também são úteis em bases multilingues ou com informação sobre produtos e serviços diferentes. Contudo, filtros de pesquisa não equivalem, por si só, a controlo de acesso. Quando existem documentos privados, a aplicação tem de verificar a identidade e as permissões do utilizador e aplicar essas restrições antes de disponibilizar conteúdos ao modelo. Uma instrução dada ao chatbot não substitui a autorização técnica.
O que o modelo recebe realmente
Numa arquitetura deste tipo, o modelo não recebe automaticamente todos os documentos indexados. Recebe os excertos selecionados, juntamente com as instruções e o restante contexto disponibilizado pela aplicação.
Por isso, «a resposta está naquele PDF» não basta para concluir que o chatbot deveria conhecê-la. É necessário verificar se o PDF foi corretamente processado, se a passagem foi recuperada e se chegou ao modelo com as condições necessárias. Conteúdo disponível e conteúdo efetivamente recuperado são coisas diferentes.
A estrutura dos documentos influencia a pesquisa
Uma base de conhecimento beneficia de títulos claros, secções coerentes e informação explícita. Uma frase vaga como «Temos soluções flexíveis para diferentes necessidades» não permite recuperar preços, prazos ou limites que nunca foram documentados.
O cuidado deve ser maior com os PDFs. Um ficheiro aceite pela plataforma não garante que o texto tenha sido extraído corretamente: páginas digitalizadas como imagem, cabeçalhos repetidos, tabelas e colunas podem prejudicar o conteúdo indexado. Convém testar a recuperação de passagens concretas, em vez de confirmar apenas que o carregamento terminou.
Tabelas exigem atenção às relações entre valores
Considere uma tabela de características de planos:
| Plano | Utilizadores | Armazenamento |
|---|---|---|
| Base | 3 | 10 GB |
| Pro | 10 | 100 GB |
Se a extração misturar linhas e colunas, o sistema pode associar 100 GB ao plano errado. Quando a informação é importante, deve testar-se se as perguntas devolvem o plano, o valor e o respetivo cabeçalho. Em determinadas situações, uma descrição textual complementar ajuda a preservar essas relações.
Em documentação disponível em português, inglês e espanhol, os testes também devem contemplar perguntas no idioma da fonte e perguntas num idioma diferente. Siglas, nomes de produtos não traduzidos e variantes regionais podem influenciar os resultados. Filtrar sempre pelo idioma da pergunta não é necessariamente correto se a resposta estiver documentada apenas noutra língua.
Atualização e avaliação: descobrir onde a resposta falhou
Alterar uma página no WordPress não significa que o índice da base de conhecimento seja atualizado imediatamente. Conforme a solução utilizada, pode ser necessário sincronizar a fonte, reprocessar documentos ou voltar a indexá-los. Também é importante impedir que versões antigas continuem a competir com as atuais.
Quando um chatbot responde incorretamente, o diagnóstico deve separar a recuperação de informação da geração da resposta:
- Confirmar a fonte: existe informação suficiente, clara e correta para responder à pergunta?
- Verificar a indexação: a versão atual foi importada e processada corretamente?
- Inspecionar os resultados: que excertos foram recuperados, de que documentos vieram e em que ordem aparecem?
- Conferir o contexto e os filtros: a resposta exige uma exceção, outra passagem ou um documento excluído da pesquisa?
- Ajustar apenas o necessário: rever a divisão em blocos, a sobreposição, a pesquisa híbrida ou a ordenação quando os resultados mostrarem uma falha concreta.
Vale a pena repetir o teste com várias formulações equivalentes, como «Qual é a garantia?», «Quantos anos de garantia tenho?» e «Durante quanto tempo estou coberto?». Uma pesquisa que funciona apenas com determinada frase pode ser pouco robusta.
Para acompanhar a qualidade, bastam inicialmente alguns critérios objetivos:
| Critério | Pergunta de avaliação |
|---|---|
| Fonte correta | O documento necessário apareceu nos resultados? |
| Passagem relevante | O excerto certo ficou entre os primeiros resultados? |
| Contexto completo | Regra, condições e exceções foram recuperadas? |
| Ruído | Quantos resultados são redundantes ou não ajudam? |
| Robustez | Formulações equivalentes encontram a mesma informação? |
Estas verificações ajudam a perceber se a falha está na documentação, na preparação dos blocos, nos filtros, na pesquisa ou na geração final. Também evitam alterar o tamanho dos blocos por tentativa e erro quando o verdadeiro problema é uma fonte desatualizada ou mal extraída.
Conclusão
Uma base de conhecimento não se torna fiável apenas por reunir muitos documentos ou utilizar embeddings. A sua utilidade depende de conseguir recuperar a passagem certa, com o contexto necessário, no momento da pergunta.
Na avaliação de um chatbot, faz sentido começar por verificar as fontes, a indexação e os resultados da pesquisa antes de atribuir todas as respostas erradas ao modelo de IA. É essa análise que permite escolher correções proporcionais ao problema.