

«Queremos treinar o chatbot com o nosso website.» A expressão é comum, mas pode descrever necessidades diferentes: responder sobre serviços e políticas, consultar documentação, manter determinado tom ou encaminhar pedidos. Tratar tudo como treino do modelo conduz, frequentemente, a uma solução mais complexa do que o necessário.
Num website empresarial, o principal desafio costuma ser garantir que o assistente encontra informação correta, atualizada e adequada a quem está a fazer a pergunta. Uma base de conhecimento bem preparada é, muitas vezes, o ponto de partida.
O que significa, afinal, «treinar o chatbot»?
Os modelos de linguagem utilizados nos chatbots já passaram por um treino prévio. Quando uma empresa adiciona páginas, artigos ou PDFs a uma plataforma, isso não significa necessariamente que esteja a alterar o modelo. Pode estar apenas a criar um conjunto de conteúdos que o assistente consegue consultar.
Convém distinguir o que se pretende melhorar:
| Necessidade | Abordagem a avaliar primeiro |
|---|---|
| Responder sobre serviços, manuais, políticas ou preços publicados | Base de conhecimento e pesquisa da informação relevante |
| Consultar disponibilidade, encomendas ou preços personalizados | Integração com o sistema de origem, através de uma API ou outra ligação controlada |
| Definir tom, âmbito e estrutura das respostas | Instruções claras (prompt) e exemplos de resposta |
| Melhorar uma classificação ou tarefa repetitiva que continua a falhar | Avaliações sistemáticas e, se for adequado e estiver disponível, fine-tuning |
Estas abordagens podem coexistir. Um chatbot integrado num website pode consultar documentação, obter dados de um sistema externo e seguir instruções sobre a forma de responder. Por outro lado, para meia dúzia de perguntas fixas, uma FAQ ou regras simples podem ser suficientes.
Como funciona uma base de conhecimento com RAG
Uma base de conhecimento reúne as fontes que o chatbot pode usar para responder: páginas do website, documentação, perguntas frequentes ou outros conteúdos aprovados. Quando existe pesquisa sobre esses conteúdos, o sistema pode recuperar informação relacionada com a pergunta sem a incorporar permanentemente nos parâmetros do modelo.
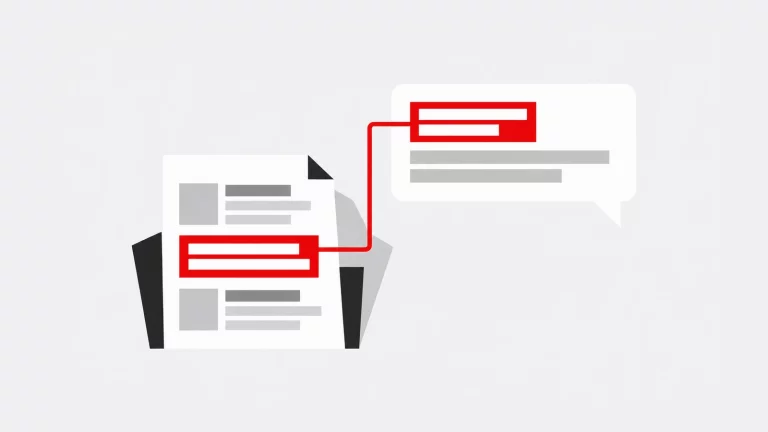
Uma arquitetura comum é o RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação de informação). O processo pode ser resumido em três etapas:
- Os documentos são processados, divididos quando necessário e indexados para pesquisa.
- Quando chega uma pergunta, o sistema procura os excertos mais relevantes, por pesquisa textual, semântica ou por uma combinação das duas.
- Os excertos recuperados são fornecidos ao modelo para ajudar a construir a resposta.
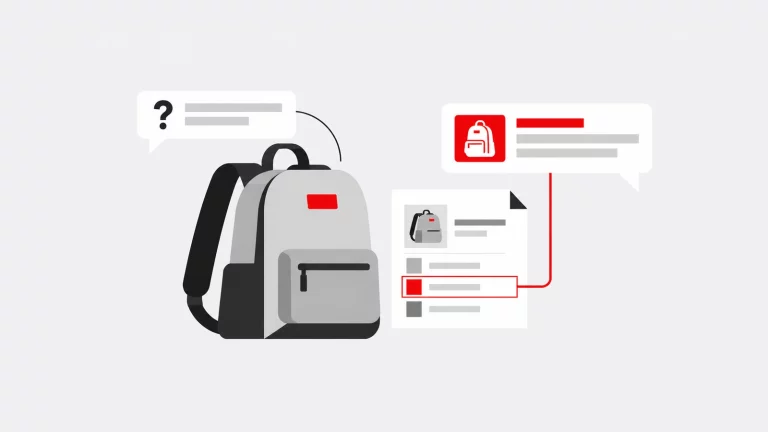
Imagine uma loja online cujo documento oficial indica entregas em Portugal Continental no prazo habitual de 3 a 5 dias úteis. Ao perguntar «Qual é o prazo de entrega?», o visitante pode receber uma resposta baseada nesse documento, idealmente com indicação da fonte.
Se o prazo passar para 5 a 7 dias úteis, a empresa atualiza o documento, confirma a sincronização ou reindexação e repete os testes. Não precisa de voltar a treinar o modelo para corrigir esse facto. Deve, contudo, confirmar que o conteúdo antigo deixou de ser recuperado: ter a informação certa na base não garante, por si só, que a resposta será correta.
O que distingue uma boa base de conhecimento
Carregar muitos ficheiros não é sinónimo de qualidade. Uma base com documentos contraditórios, versões antigas ou texto mal extraído pode apresentar piores resultados do que outra mais pequena e organizada.
Há cinco aspetos especialmente importantes:
- Fontes oficiais e versões.
- Defina qual é o documento válido para cada assunto. Se coexistirem políticas de 2025 e 2026, retire a antiga da pesquisa corrente ou aplique regras claras de versão e prioridade.
- Conteúdo legível e coerente.
- Reveja duplicados, páginas vagas e PDFs com tabelas ou texto extraído incorretamente. A informação deve fazer sentido mesmo quando é consultada fora da página original.
- Divisão em excertos (chunking).
- Os excertos precisam de preservar as condições relevantes. Se «O serviço inclui assistência prioritária» ficar separado de «Apenas nos contratos anuais», a resposta pode omitir uma restrição essencial.
- Metadados e filtros.
- Atributos como idioma, produto, estado e versão podem ajudar a restringir a pesquisa, desde que a solução utilizada suporte esses filtros. Um documento antigo não deve competir com a fonte em vigor.
- Permissões de acesso.
- O facto de um documento estar indexado não autoriza a sua divulgação. Conteúdos internos ou específicos de cada cliente exigem autenticação e controlo de permissões no sistema que os disponibiliza; uma instrução para o chatbot «não revelar» informação não substitui essa proteção.
Este trabalho envolve gestão da informação, não apenas configuração de inteligência artificial. Também exige manutenção: quando mudam preços, condições ou documentação, a fonte oficial deve ser corrigida primeiro. Para valores que mudam constantemente, como existências ou o estado de uma encomenda, pode ser mais adequado consultar diretamente o sistema responsável por esses dados.
Quando pode justificar-se o fine-tuning?
O fine-tuning é um processo de treino adicional que adapta o comportamento de um modelo a partir de exemplos. Pode ajudar em tarefas específicas, como classificar mensagens em «comercial», «suporte» ou «faturação», ou produzir respostas com um estilo muito particular e consistente.
Não funciona, porém, como uma base de dados editável. Incluir «preço = 49 €» num conjunto de treino não permite garantir que o chatbot devolverá sempre esse valor nem torna simples a sua atualização. Para factos de negócio, continua a ser preferível uma fonte explícita e verificável.
Antes de considerar fine-tuning, vale a pena experimentar instruções mais precisas, alguns exemplos de respostas corretas e, quando aplicável, funcionalidades de saída estruturada. Se isso resolver o problema, não há vantagem evidente em acrescentar uma etapa de treino.
O fine-tuning exige exemplos consistentes, testes comparáveis e manutenção. A sua disponibilidade também depende do fornecedor e do modelo. Pode ser combinado com RAG — um fornece contexto atualizado; o outro ajusta uma tarefa específica —, mas essa complexidade deve ser justificada por resultados medidos.
Testar a pesquisa e as respostas antes de complicar a solução
Uma base de conhecimento deve ser avaliada com perguntas representativas dos visitantes, não apenas com uma demonstração que correu bem. «Quanto demora?», «Qual é o prazo?» e «Em quantos dias entregam?» podem ter de encontrar a mesma fonte, apesar de serem formuladas de maneira diferente.
Um procedimento prático é:
- Preparar perguntas e resultados esperados. Incluir casos frequentes, exceções, perguntas sem resposta disponível e informação que determinados utilizadores não estão autorizados a consultar.
- Verificar a recuperação. Confirmar que o documento encontrado é o correto, está atualizado e contém a condição necessária. Se falhar, investigar a fonte, a indexação, a divisão em excertos e os filtros.
- Avaliar a resposta. Confirmar se respeita o documento, apresenta a fonte quando apropriado e reconhece quando não dispõe de informação suficiente. A recuperação correta não impede uma interpretação errada do modelo.
- Comparar antes e depois. Repetir os mesmos testes quando se alteram conteúdos, instruções, configurações de pesquisa ou modelo. Assim é possível perceber se a mudança melhorou efetivamente o resultado.
Estas avaliações sistemáticas, muitas vezes chamadas evals, ajudam a localizar o problema. Se a informação certa não aparece nos resultados, a prioridade está na pesquisa ou na base. Se aparece, mas o chatbot responde mal, importa rever as instruções, o contexto fornecido ou o modelo. Só depois faz sentido avaliar técnicas de otimização mais exigentes.
Conclusão
A qualidade de um chatbot empresarial depende tanto da informação a que tem acesso como da forma como a utiliza. Uma base de conhecimento bem estruturada torna os conteúdos mais fáceis de atualizar, verificar e relacionar com as respostas — embora não elimine a necessidade de testes nem de controlo de acesso.
A prioridade deve ser identificar a necessidade real: consultar factos atualizados, aceder a dados de negócio ou melhorar um comportamento específico. Na maioria dos casos, organizar as fontes, escolher a integração adequada e testar as respostas é um investimento inicial mais sensato do que começar por treinar novamente um modelo.